6.4.1 通用的高速缓存存储器组织结构
6.4.1 通用的高速缓存存储器组织结构
考虑一个计算机系统,其中每个存储器地址有 m 位,形成 M=2m 个不同的地址。如图 6-25a 所示,这样一个机器的高速缓存被组织成一个有 S=2s 个高速缓存组(cache set)的数组。每个组包含 E 个高速缓存行(cache line)。每个行是由一个 B=2b 字节的数据块(block)组成的,一个有效位(valid bit)指明这个行是否包含有意义的信息,还有 t=m-(b+s) 个标记位(tag bit)(是当前块的内存地址的位的一个子集),它们唯一地标识存储在这个高速缓存行中的块。
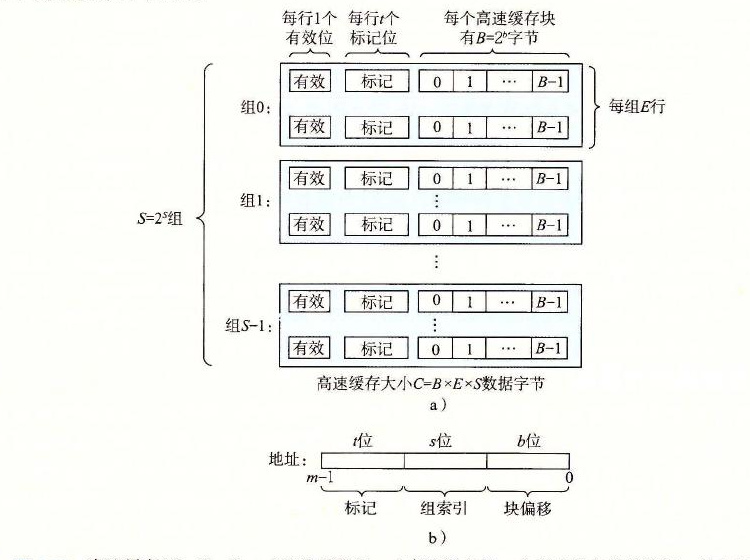
图 6-25 高速缓存(S、E、B、m)的通用组织。a)高速缓存是一个高速缓存组的数组。每个组包含一个或多个行,每个行包含一个有效位、一些标记位,以及一个数据块;b)高速缓存的结构将 m 个地址位划分成了 t 个标记位、s 个组索引位和 b 个块偏移位
一般而言,高速缓存的结构可以用元组 (S, E, B, m) 来描述。高速缓存的大小(或容量)C 指的是所有块的大小的和。标记位和有效位不包括在内。因此,C=S×E×B。
当一条加载指令指示 CPU 从主存地址 A 中读一个字时,它将地址 A 发送到高速缓存。如果高速缓存正保存着地址 A 处那个字的副本,它就立即将那个字发回给 CPU。那么高速缓存如何知道它是否包含地址 A 处那个字的副本的呢?高速缓存的结构使得它能通过简单地检查地址位,找到所请求的字,类似于使用极其简单的哈希函数的哈希表。下面介绍它是如何工作的:
参数 S 和 B 将 m 个地址位分为了三个字段,如图 6-25b 所示。A 中 s 个组索引位是一个到 S 个组的数组的索引。第一个组是组 0,第二个组是组 1,依此类推。组索引位被解释为一个无符号整数,它告诉我们这个字必须存储在哪个组中。一旦我们知道了这个字必须放在哪个组中,A 中的 t 个标记位就告诉我们这个组中的哪一行包含这个字(如果有的话)。当且仅当设置了有效位并且该行的标记位与地址 A 中的标记位相匹配时,组中的这一行才包含这个字。一旦我们在由组索引标识的组中定位了由标号所标识的行,那么 b 个块偏移位给出了在 B 个字节的数据块中的字偏移。
你可能已经注意到了,对高速缓存的描述使用了很多符号。图 6-26 对这些符号做了个小结,供你参考。
| 基本参数 | 描述 |
|---|---|
| S=2s | 组数 |
| E | 每个组的行数 |
| B=2b | 块大小(字节) |
| m=log2(M) | (主存)物理地址位数 |
| 衍生出来的量 | 描述 |
|---|---|
| M=2m | 内存地址的最大数量 |
| s=log2(S) | 组索引位数量 |
| b=log2(B) | 块偏移位数量 |
| t=m-(s+b) | 标记位数量 |
| C=B×E×S | 不包括像有效位和标记位这样开销的高速缓存大小(字节) |
图 6-26 高速缓存参数小结
练习题 6.9
下表给出了几个不同的高速缓存的参数。确定每个高速缓存的高速缓存组数(S)、标记位数(t)、组索引位数(s)以及块偏移位数(b)。
高速缓存 m C B E S t s b 1. 32 1024 4 1 2. 32 1024 8 4 3. 32 1024 32 32