5.3 程序示例
5.3 程序示例
为了说明一个抽象的程序是如何被系统地转换成更有效的代码的,我们将使用一个基于图 5-3 所示向量数据结构的运行示例。向量由两个内存块表示:头部和数据数组。头部是一个声明如下的结构:
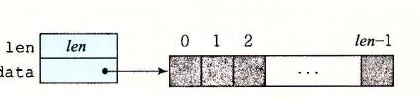
图 5-3 向量的抽象数据类型。向量由头信息加上指定长度的数组来表示。
/* Create abstract data type for vector */
typedef struct {
    long len;
    data_t *data;
} vec_rec, *vec_ptr;
这个声明用 data_t 来表示基本元素的数据类型。在测试中,我们度量代码对于整数(C 语言的 int 和 long)和浮点数(C 语言的 float 和 double)数据的性能。为此,我们会分别为不同的类型声明编译和运行程序,就像下面这个例子对数据类型 long 一样:
typedef long data_t;我们还会分配一个 len 个 data_t 类型对象的数组,来存放实际的向量元素。
图 5-4 给出的是一些生成向量、访问向量元素以及确定向量长度的基本过程。一个值得注意的重要特性是向量访问程序 get_vec_element,它会对每个向量引用进行边界检查。这段代码类似于许多其他语言(包括 Java)所使用的数组表示法。边界检查降低了程序出错的机会,但是它也会减缓程序的执行。
/* Create vector of specified length */
vec_ptr new_vec(long len)
{
    /* Allocate header structure */
    vec_ptr result = (vec_ptr) malloc(sizeof(vec_rec));
    data_t *data = NULL;
    if (!result)
        return NULL;  /* Couldn't allocate storage */
    result->len = len;

    /* Allocate array */
    if (len > 0) {
        data = (data_t *)calloc(len, sizeof(data_t));
        if (!data) {
            free((void *) result);
            return NULL;  /* Couldn't allocate storage */
        }
    }

    /* Data will either be NULL or allocated array */
    result->data = data;
    return result;
}

/*
 * Retrieve vector element and store at dest.
 * Return 0 (out of bounds) or 1 (successful)
 */
int get_vec_element(vec_ptr v, long index, data_t *dest)
{
    if (index < 0 || index >= v->len)
        return 0;
    *dest = v->data[index];
    return 1;
}

/* Return length of vector */
long vec_length(vec_ptr v)
{
    return v->len;
}
图 5-4 向量抽象数据类型的实现。在实际程序中,数据类型 data_t 被声明为 int、long、float 或 double。
作为一个优化示例,考虑图 5-5 中所示的代码,它使用某种运算,将一个向量中所有的元素合并成一个值。通过使用编译时常数 IDENT 和 OP 的不同定义,这段代码可以重编译成对数据执行不同的运算。特别地,使用声明:
#define IDENT 0
#define OP +
它对向量的元素求和。使用声明:
#define IDENT 1
#define OP *
它计算的是向量元素的乘积。
/* Implementation with maximum use of data abstraction */
void combine1(vec_ptr v, data_t *dest)
{
    long i;

    *dest = IDENT;
    for (i = 0; i < vec_length(v); i++) {
        data_t val;
        get_vec_element(v, i, &val);
        *dest = *dest OP val;
    }
}
图 5-5 合并运算的初始实现。使用基本元素 IDENT 和合并运算 OP 的不同声明,我们可以测量该函数对不同运算的性能。
在我们的讲述中,我们会对这段代码进行一系列的变化,写出这个合并函数的不同版本。为了评估性能变化,我们会在一个具有 Intel Core i7 Haswell 处理器的机器上测量这些函数的 CPE 性能,这个机器称为参考机。3.1 节中给出了一些有关这个处理器的特性。这些测量值刻画的是程序在某个特定的机器上的性能,所以在其他机器和编译器组合中不保证有同等的性能。不过,我们把这些结果与许多不同编译器/处理器组合上的结果做了比较,发现也非常相似。
我们会进行一组变换,发现有很多只能带来很小的性能提高,而其他的能带来更巨大的效果。确定该使用哪些变换组合确实是编写快速代码的“魔术(black art)”。有些不能提供可测量的好处的组合确实是无效的,然而有些组合是很重要的,它们使编译器能够进一步优化。根据我们的经验,最好的方法是实验加上分析:反复地尝试不同的方法,进行测量,并检查汇编代码表示以确定底层的性能瓶颈。
作为一个起点,下表给出的是 combine1 的 CPE 度量值,它运行在我们的参考机上,尝试了操作(加法或乘法)和数据类型(长整数和双精度浮点数)的不同组合。使用多个不同的程序,我们的实验显示 32 位整数操作和 64 位整数操作有相同的性能,除了涉及除法操作的代码之外。同样,对于操作单精度和双精度浮点数据的程序,其性能也是相同的。因此在表中,我们将只给出整数数据和浮点数据各自的结果。
| 函数 | 方法 | 整数 + |
整数 * |
浮点数 + |
浮点数 * |
|---|---|---|---|---|---|
combine1 |
抽象的未优化的 | 22.68 | 20.02 | 19.98 | 20.18 |
combine1 |
抽象的 -O1 |
10.12 | 10.12 | 10.17 | 11.14 |
可以看到测量值有些不太精确。对于整数求和的 CPE 数更像是 23.00,而不是 22.68;对于整数乘积的 CPE 数则是 20.0 而非 20.02。我们不会“捏造”数据让它们看起来好看一点儿,只是给出了实际获得的测量值。有很多因素会使得可靠地测量某段代码序列需要的精确周期数这个任务变得复杂。检查这些数字时,在头脑里把结果向上或者向下取整几百分之一个时钟周期会很有帮助。
未经优化的代码是从 C 语言代码到机器代码的直接翻译,通常效率明显较低。简单地使用命令行选项 -O1,就会进行一些基本的优化。正如可以看到的,程序员不需要做什么,就会显著地提高程序性能——超过两个数量级。通常,养成至少使用这个级别优化的习惯是很好的。(使用 -Og 优化级别能得到相似的性能结果。)在剩下的测试中,我们使用 -O1 和 -O2 级别的优化来生成和测量程序。